AIの学習は防ぎたい、でもAIには推薦されたい:ウェブサイトは全開か全閉かの二択でなくていい
人材をめぐる不安では、「人は何を身につけるべきか」に目が向きがちだが、私はむしろ反対側を見てみたい。専門職として確かな腕を持っているのに、その人のウェブサイトには、AIがその腕前を理解するための入口すら残されていないかもしれない。
私の主張は、どちらからも歓迎されないかもしれない。AIに推薦されたいからといって、あらゆるAIによる自由な利用をまず認める必要はない。モデルの学習を拒むからといって、検索の入口まで一緒に閉ざす必要もない。
この二つをセットにして都合がいいのは、プラットフォームであって、必ずしも事業者ではない。
入口の掲示であって、セキュリティシステムではない
ウェブサイトのルートディレクトリにあるrobots.txtでは、クローラーごとに、どのパスの取得を許可し、禁止するかを示せる。ただし、これはクローラーが従うためのルールであって、暗証番号付きの錠でも、完全な利用許諾契約でもない。ルールを無視する訪問者が来ても、掲示から突然手が生えて相手を止めてくれるわけではない。機密データは、やはりログイン、アクセス権限、サーバーの保護で守らなければならない。
もう一つ、混同されやすい点がある。**検索用のインデックスを作ることと、モデルの学習データを集めることは、用途が異なる。**たとえばOpenAIの公式ドキュメントでは、検索クローラーのOAI-SearchBotと学習クローラーのGPTBotを分けて説明している。サイト運営者は用途に応じてルールを設定できる。実装する際には各社のドキュメントを確認する必要があり、一社の名称をすべてのプラットフォームに当てはめることはできない。クローラーに関する公式説明
これで、「AIを遮断すれば姿が消える」という言い方も、脅しの根拠が少し薄れる。
読まれても、誰も来ないかもしれない
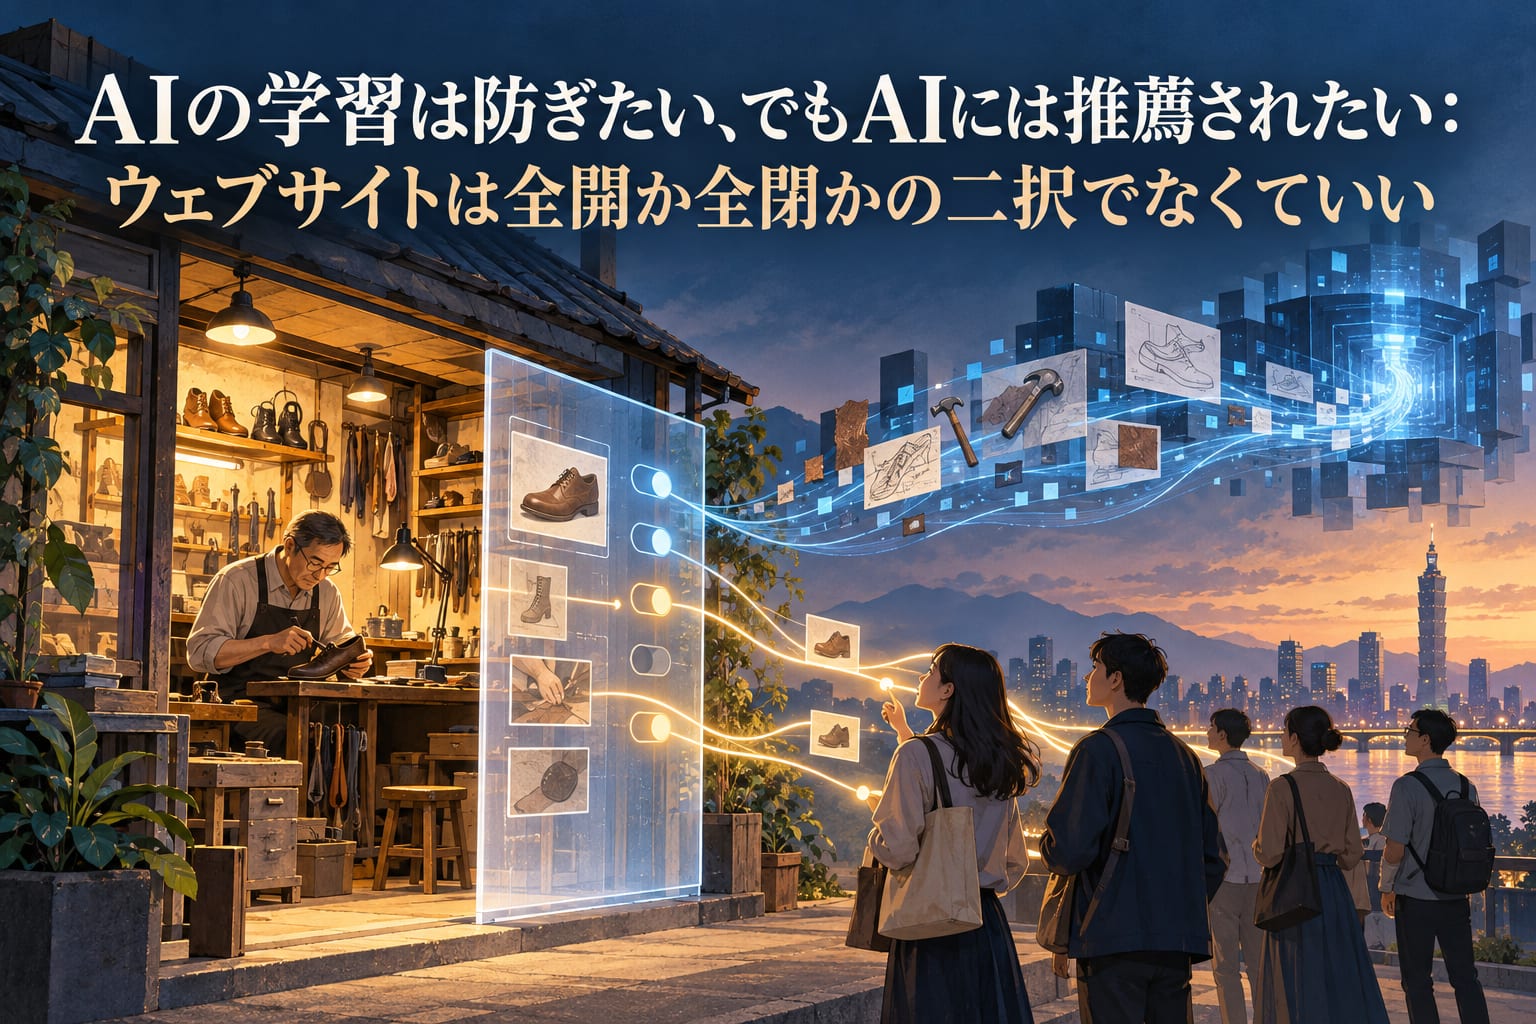
台南の靴修理店を想像してみてほしい。職人は、革底の交換、特殊な靴素材への対応、予約方法をわかりやすく書いている。誰かがAIに「近くで古い革靴を修理できるところは?」と尋ねる。こうした内容を取得し、理解できれば、推薦の根拠になる可能性がある。
ただし、「取得を許可する」ことは入口にすぎず、推薦の保証ではない。ページを読み取れるか、情報が明確か、対応地域がはっきりしているかは、その後の判断に影響する。Allowの一行で、職人の信頼性が生まれるわけではない。
マーケティング担当者が本当に頭を抱えるのは、その先だ。AIがサービス、住所、注意事項をその場ですべて説明してしまい、ユーザーがウェブサイトを訪れなくなるかもしれない。
職人は「電話が鳴ればそれでいい」と、割に合うと感じるかもしれない。一方、解説記事で広告収入を得ている専門ライターは、自分のコンテンツが他人の無料の窓口係になったと感じるかもしれない。どちらも露出を必要としているが、受け入れられる交換条件はまったく違う。
誰に交換条件を交渉する力があるのか?
私はrobots.txtを用途についての掲示と捉えたい。小規模事業者に最も欠けているのは、多くの場合、気前のよさではなく、交換条件を区別する力だからだ。
営業時間やサービス範囲は、検索で見つけてもらいたいだろう。一方、有料教材や顧客事例の詳細には、別のアクセス方法が必要かもしれない。技術的な設定が示すのは取得に関する意向であり、著作権や個人情報に関する責任まで、数行の文字に丸投げすることはできない。
ここには、規制をめぐる現実的なせめぎ合いがある。プラットフォームが露出とデータ利用を強く結びつけすぎれば、事業者の「自発的な開放」は、推薦リストから消えることへの恐れにすぎないかもしれない。逆に、全面的な遮断にも代償がある——小さな店は、チェーン店と一緒に比較してもらう機会すら減ってしまうかもしれない。
靴修理の職人が管理画面を開くと、サイトへのアクセスは増えていないのに、電話は二件増えていた。彼が知りたいのは「AIが自分のサイトを読んだか」ではなく、お客さんが「AIがあなたを推薦してくれた」と言うとき、自分のどの技に目を留めたのかということだ。