擋住 AI 訓練,卻想被 AI 推薦:網站不必只有全開或全關
人才焦慮常把問題放在「人要學會什麼」,我反而想看另一端:一位專業工作者明明很有本事,他的網站,卻可能連讓 AI 理解這份本事的入口都沒留。
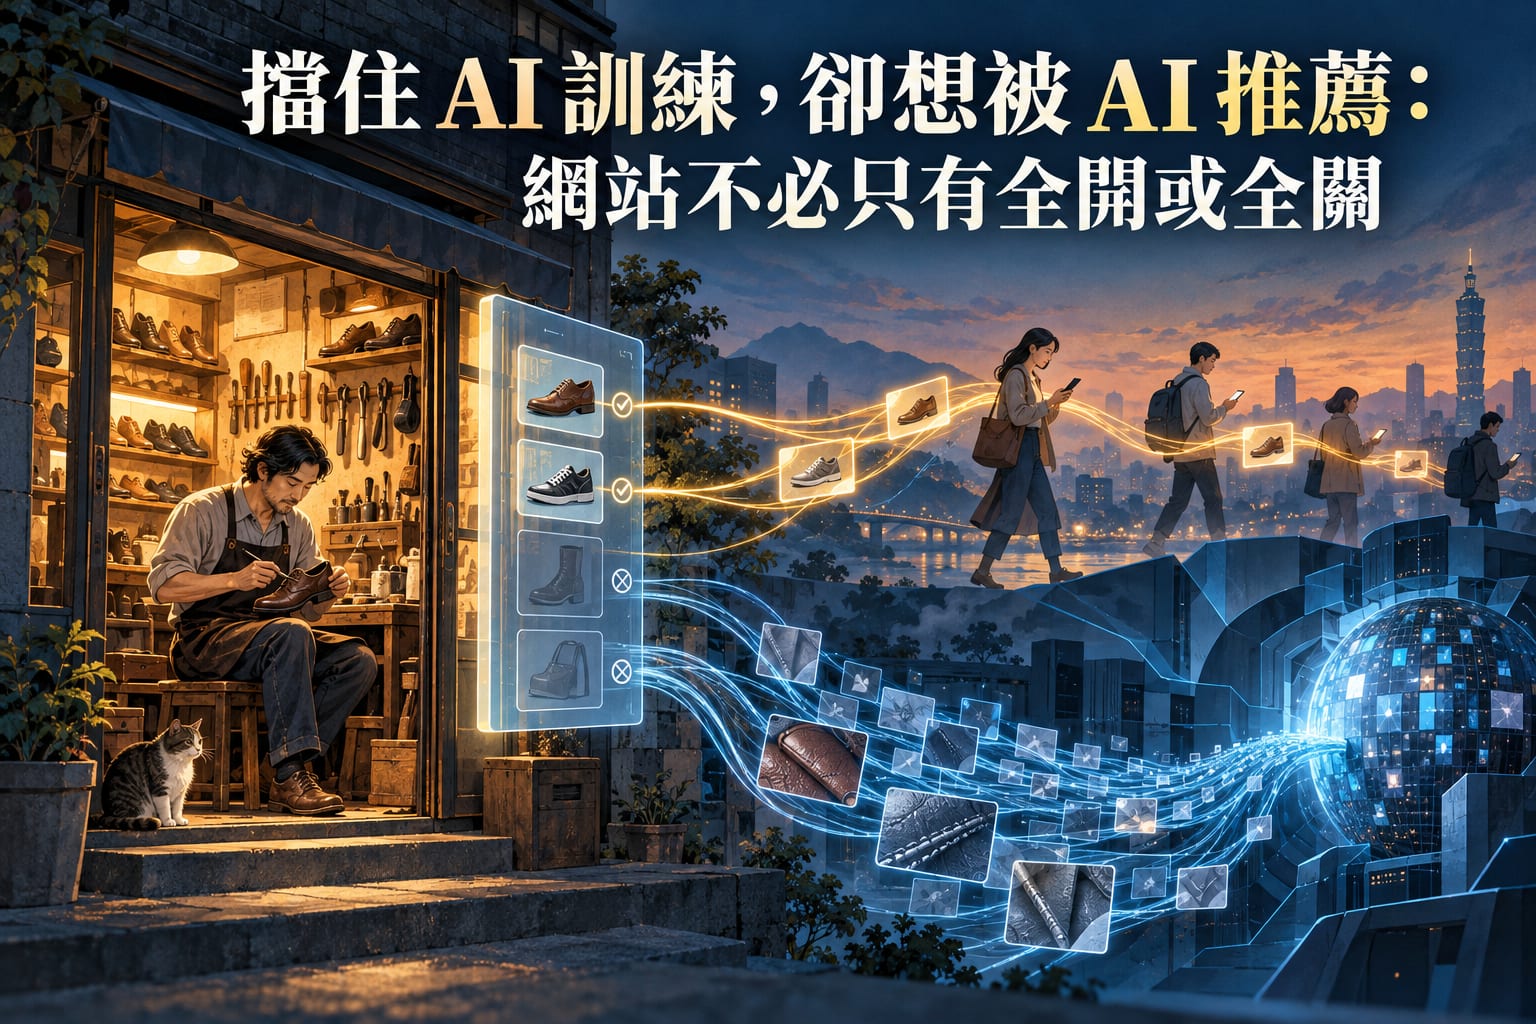
我的主張可能兩邊都不討好:想被 AI 推薦,不必先同意讓所有 AI 任意取用;拒絕模型訓練,也不必把搜尋入口一起封死。
把這兩件事綁成套餐,方便的是平台,未必是商家。
門口告示,不是保全系統
網站根目錄的 robots.txt,可以對不同爬蟲表達哪些路徑允許或禁止抓取。但它是供爬蟲遵循的規則,不是密碼鎖,也不是完整的授權契約。遇到不理會規則的訪客,告示不會突然長出手來攔人。敏感資料仍得靠登入、權限與伺服器防護。
另一個容易混淆的地方:**替搜尋建立索引,與蒐集模型訓練資料,是不同用途。**例如 OpenAI 的官方文件就分別說明搜尋爬蟲 OAI-SearchBot 與訓練爬蟲 GPTBot;站方可以依用途設定規則。實作仍須核對各家文件,不能把一家的名稱套給所有平台。官方爬蟲說明
這讓「擋 AI 就會消失」的說法,少了一點恐嚇的本錢。
被讀到,也可能沒人上門
想像一間台南修鞋店。師傅把皮底更換、特殊鞋材處理、預約方式寫得清清楚楚。有人問 AI:「附近哪裡能修老皮鞋?」這些內容若能被取得與理解,就可能成為推薦依據。
但「允許抓取」只是入口,不是推薦保證。頁面能不能被讀取、資訊是否明確、服務地區是否清楚,都會影響後續判讀;一行 Allow 不會替師傅生出可信度。
行銷人真正尷尬的地方在後面:AI 可能把服務、地址、注意事項直接講完,使用者不再點進網站。
師傅可能覺得划算:「電話有響就好。」靠教學文章帶來廣告收入的專業作者,卻可能覺得自己的內容成了別人的免費櫃員。兩者都需要曝光,能承受的交換條件卻完全不同。
誰有能力談交換?
我傾向把 robots.txt 看成一張用途告示,因為小商家最缺的,往往不是大方,而是區分交換條件的能力。
營業時間、服務範圍,可以希望被搜尋;付費教材、客戶案例細節,則可能需要另一套存取安排。技術設定表達的是抓取偏好,著作權與個資責任,仍不能交給幾行文字包辦。
這裡的監管張力很實際:平台若把曝光與資料利用綁得太緊,商家的「自願開放」,可能只是害怕從推薦名單消失。反過來,全面封鎖也有代價——小店可能連與連鎖品牌一起被比較的機會都少了。
修鞋師傅打開後台,看見網站流量沒增加,電話倒是多了兩通。他想知道的不是「AI 有沒有讀我」,而是那位客人說「AI 推薦你」時,究竟看見了他的哪一項手藝。