挡住 AI 训练,却想被 AI 推荐:网站不必只有全开或全关
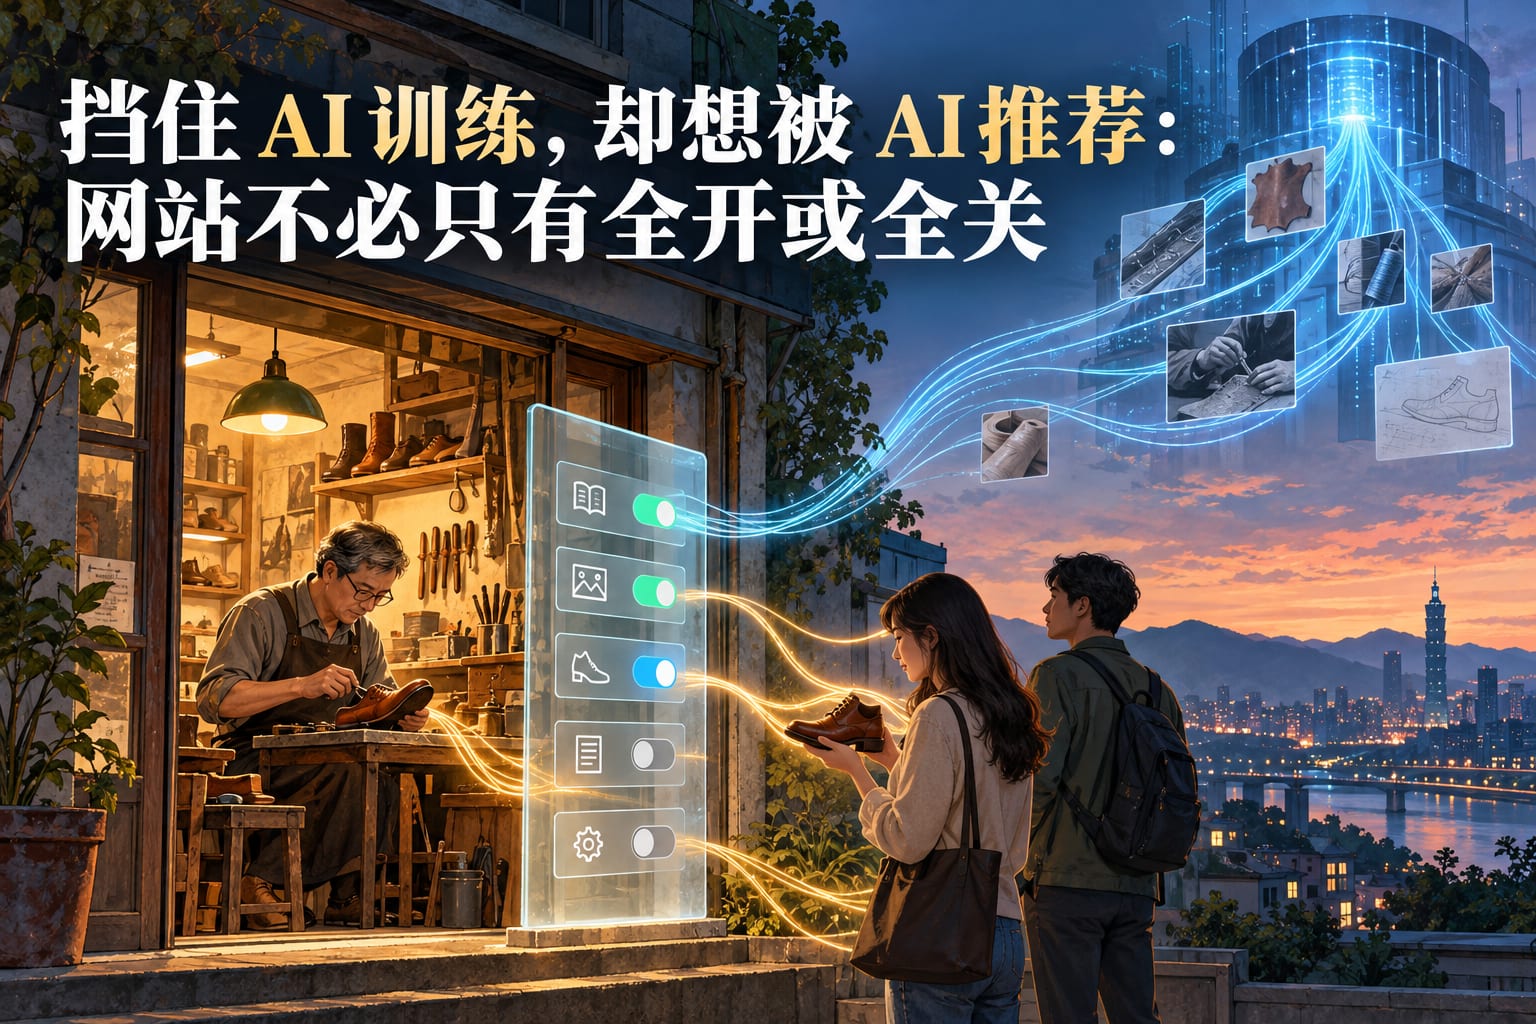
人才焦虑常把问题放在“人要学会什么”,我反而想看另一端:一位专业工作者明明很有本事,他的网站,却可能连让 AI 理解这份本事的入口都没留。
我的主张可能两边都不讨好:想被 AI 推荐,不必先同意让所有 AI 任意取用;拒绝模型训练,也不必把搜索入口一起封死。
把这两件事绑成套餐,方便的是平台,未必是商家。
门口告示,不是安保系统
网站根目录的 robots.txt,可以对不同爬虫表达哪些路径允许或禁止抓取。但它是供爬虫遵循的规则,不是密码锁,也不是完整的授权合同。遇到不理会规则的访客,告示不会突然长出手来拦人。敏感数据仍得靠登录、权限与服务器防护。
另一个容易混淆的地方:**为搜索建立索引,与收集模型训练数据,是不同用途。**例如 OpenAI 的官方文档就分别说明搜索爬虫 OAI-SearchBot 与训练爬虫 GPTBot;网站方可以依用途设置规则。实施仍须核对各家文档,不能把一家的名称套给所有平台。官方爬虫说明
这让“挡 AI 就会消失”的说法,少了一点恐吓的本钱。
被读到,也可能没人上门
想象一间台南修鞋店。师傅把皮底更换、特殊鞋材处理、预约方式写得清清楚楚。有人问 AI:“附近哪里能修老皮鞋?”这些内容若能被获取与理解,就可能成为推荐依据。
但“允许抓取”只是入口,不是推荐保证。页面能不能被读取、信息是否明确、服务地区是否清楚,都会影响后续判断;一行 Allow 不会替师傅生出可信度。
营销人真正尴尬的地方在后面:AI 可能把服务、地址、注意事项直接讲完,用户不再点进网站。
师傅可能觉得划算:“电话有响就好。”靠教学文章带来广告收入的专业作者,却可能觉得自己的内容成了别人的免费柜员。两者都需要曝光,能承受的交换条件却完全不同。
谁有能力谈交换?
我倾向把 robots.txt 看成一张用途告示,因为小商家最缺的,往往不是大方,而是区分交换条件的能力。
营业时间、服务范围,可以希望被搜索;付费教材、客户案例细节,则可能需要另一套访问安排。技术设置表达的是抓取偏好,著作权与个人信息责任,仍不能交给几行文字包办。
这里的监管张力很实际:平台若把曝光与数据利用绑得太紧,商家的“自愿开放”,可能只是害怕从推荐名单消失。反过来,全面封锁也有代价——小店可能连与连锁品牌一起被比较的机会都少了。
修鞋师傅打开后台,看见网站流量没增加,电话倒是多了两通。他想知道的不是“AI 有没有读我”,而是那位客人说“AI 推荐你”时,究竟看见了他的哪一项手艺。