ปิดกั้นการฝึก AI แต่ก็อยากให้ AI แนะนำ: เว็บไซต์ไม่จำเป็นต้องเปิดหมดหรือปิดหมดเท่านั้น
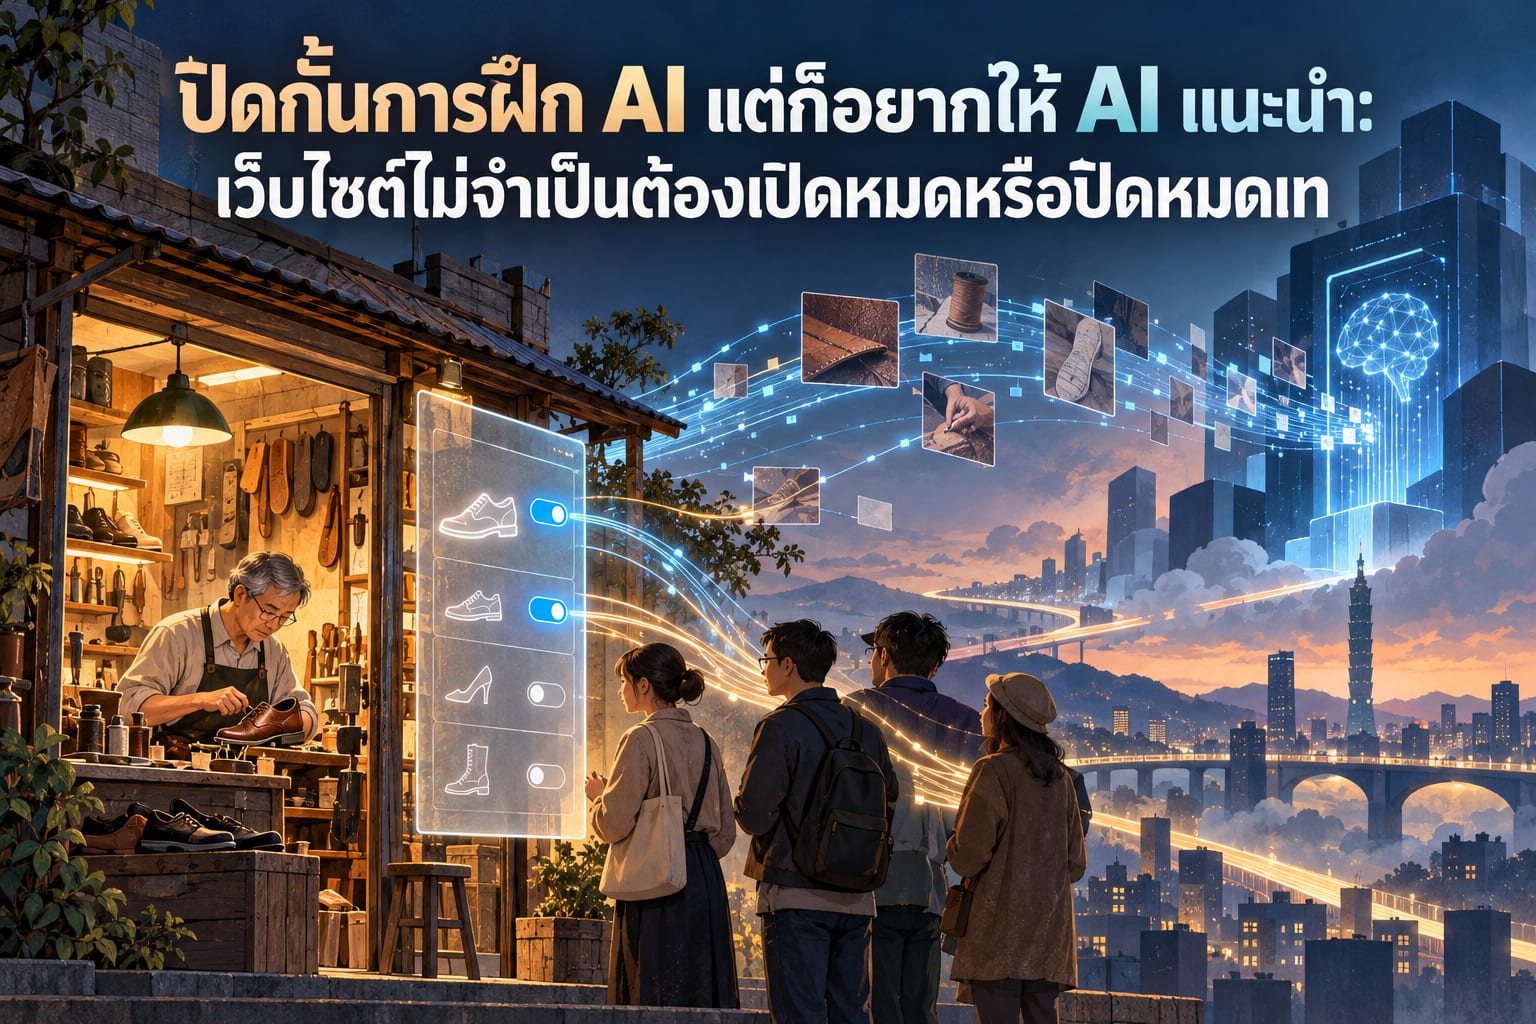
ความกังวลเรื่องทักษะของคนทำงานมักตั้งคำถามว่า “คนต้องเรียนรู้อะไร” แต่ผมกลับอยากมองอีกด้านหนึ่ง: ผู้ประกอบวิชาชีพคนหนึ่งมีความสามารถอย่างชัดเจน แต่เว็บไซต์ของเขาอาจไม่ได้เปิดช่องทางให้ AI เข้าใจความสามารถนั้นเลยด้วยซ้ำ
จุดยืนของผมอาจไม่ถูกใจทั้งสองฝ่าย: การอยากให้ AI แนะนำ ไม่จำเป็นต้องยินยอมให้ AI ทุกตัวนำเนื้อหาไปใช้ได้ตามใจเสียก่อน และการปฏิเสธการฝึกโมเดล ก็ไม่จำเป็นต้องปิดช่องทางการค้นหาไปพร้อมกันด้วย
การมัดสองเรื่องนี้เป็นแพ็กเกจเดียวกัน อำนวยความสะดวกให้แพลตฟอร์ม แต่อาจไม่ใช่ให้ผู้ประกอบการ
ป้ายประกาศหน้าประตู ไม่ใช่ระบบรักษาความปลอดภัย
ไฟล์ robots.txt ในไดเรกทอรีรากของเว็บไซต์สามารถระบุให้บอตรวบรวมข้อมูลแต่ละตัวทราบว่า เส้นทางใดอนุญาตหรือห้ามเก็บข้อมูล แต่สิ่งนี้เป็นกฎให้บอตปฏิบัติตาม ไม่ใช่กุญแจรหัสผ่าน และไม่ใช่สัญญาอนุญาตให้ใช้สิทธิที่ครบถ้วน เมื่อเจอผู้มาเยือนที่ไม่สนใจกฎ ป้ายประกาศก็ไม่ได้งอกแขนออกมาขวางใครได้ ข้อมูลอ่อนไหวยังต้องอาศัยการเข้าสู่ระบบ การกำหนดสิทธิ์ และการป้องกันฝั่งเซิร์ฟเวอร์
อีกจุดที่สับสนกันได้ง่ายคือ: การสร้างดัชนีเพื่อการค้นหา กับการรวบรวมข้อมูลสำหรับฝึกโมเดล เป็นการใช้งานคนละวัตถุประสงค์ ตัวอย่างเช่น เอกสารทางการของ OpenAI อธิบายบอตค้นหา OAI-SearchBot และบอตฝึกโมเดล GPTBot แยกจากกัน เจ้าของเว็บไซต์จึงตั้งกฎตามวัตถุประสงค์การใช้งานได้ ในการใช้งานจริงยังต้องตรวจสอบเอกสารของแต่ละราย ไม่สามารถนำชื่อของรายหนึ่งไปใช้กับทุกแพลตฟอร์มได้ คำอธิบายบอตอย่างเป็นทางการ
สิ่งนี้ทำให้คำกล่าวที่ว่า “ปิดกั้น AI แล้วจะหายไปจากสายตา” มีน้ำหนักในการขู่ให้กลัวน้อยลงอยู่บ้าง
ถูกอ่านแล้ว ก็อาจไม่มีใครเข้าร้าน
ลองนึกถึงร้านซ่อมรองเท้าแห่งหนึ่งในไถหนาน ช่างเขียนรายละเอียดเรื่องการเปลี่ยนพื้นหนัง การจัดการวัสดุรองเท้าชนิดพิเศษ และวิธีนัดหมายไว้อย่างชัดเจน มีคนถาม AI ว่า “แถวนี้มีที่ไหนซ่อมรองเท้าหนังเก่าได้บ้าง?” หากเนื้อหาเหล่านี้เข้าถึงได้และถูกทำความเข้าใจ ก็อาจกลายเป็นข้อมูลประกอบการแนะนำ
แต่ “อนุญาตให้เก็บข้อมูล” เป็นเพียงทางเข้า ไม่ใช่คำรับประกันว่าจะได้รับการแนะนำ หน้าเว็บอ่านได้หรือไม่ ข้อมูลชัดเจนหรือไม่ และระบุพื้นที่ให้บริการชัดเจนหรือไม่ ล้วนส่งผลต่อการตีความในขั้นต่อไป คำสั่ง Allow เพียงบรรทัดเดียวไม่ได้เสกความน่าเชื่อถือให้ช่าง
จุดที่ทำให้นักการตลาดลำบากใจจริง ๆ อยู่ถัดจากนั้น: AI อาจบอกบริการ ที่อยู่ และข้อควรทราบจนครบ ทำให้ผู้ใช้ไม่คลิกเข้าเว็บไซต์อีก
ช่างอาจรู้สึกว่าคุ้มค่า: “แค่มีคนโทรมาก็พอแล้ว” แต่นักเขียนผู้เชี่ยวชาญที่อาศัยบทความสอนความรู้สร้างรายได้จากโฆษณา อาจรู้สึกว่าเนื้อหาของตนกลายเป็นพนักงานบริการฟรีให้คนอื่น ทั้งสองฝ่ายต่างต้องการให้คนเห็น แต่เงื่อนไขแลกเปลี่ยนที่รับได้นั้นแตกต่างกันอย่างสิ้นเชิง
ใครมีอำนาจเจรจาเงื่อนไขแลกเปลี่ยน?
ผมมักมอง robots.txt เป็นป้ายประกาศวัตถุประสงค์การใช้งาน เพราะสิ่งที่ผู้ประกอบการรายย่อยขาดมากที่สุด มักไม่ใช่ความใจกว้าง แต่เป็นความสามารถในการแยกแยะเงื่อนไขแลกเปลี่ยน
เวลาเปิดทำการและขอบเขตบริการ อาจเป็นข้อมูลที่อยากให้ค้นหาเจอ ส่วนสื่อการสอนแบบเสียเงินและรายละเอียดกรณีศึกษาของลูกค้า อาจต้องใช้การจัดการการเข้าถึงอีกแบบหนึ่ง การตั้งค่าทางเทคนิคแสดงความประสงค์เรื่องการเก็บข้อมูล แต่ความรับผิดชอบด้านลิขสิทธิ์และข้อมูลส่วนบุคคล ยังไม่อาจฝากให้ข้อความไม่กี่บรรทัดจัดการทั้งหมดได้
ความตึงเครียดด้านการกำกับดูแลในเรื่องนี้เป็นเรื่องที่เกิดขึ้นจริง: หากแพลตฟอร์มผูกการมองเห็นเข้ากับการใช้ประโยชน์จากข้อมูลแน่นเกินไป การ “เปิดให้เข้าถึงโดยสมัครใจ” ของผู้ประกอบการ อาจเป็นเพียงความกลัวว่าจะหายไปจากรายชื่อแนะนำ ในทางกลับกัน การปิดกั้นทั้งหมดก็มีต้นทุนเช่นกัน—ร้านเล็กอาจเสียแม้แต่โอกาสที่จะถูกนำไปเปรียบเทียบกับแบรนด์เครือข่าย
ช่างซ่อมรองเท้าเปิดระบบหลังบ้าน เห็นว่ายอดเข้าชมเว็บไซต์ไม่ได้เพิ่มขึ้น แต่กลับมีคนโทรมาเพิ่มสองสาย สิ่งที่เขาอยากรู้ไม่ใช่ “AI อ่านข้อมูลของฉันหรือเปล่า” แต่เป็นตอนที่ลูกค้าคนนั้นพูดว่า “AI แนะนำร้านคุณมา” แท้จริงแล้วลูกค้าได้เห็นฝีมือด้านใดของเขา